Para que serve
O RDX LiveScore mostra, em tempo real, o placar de uma competição de radioamador enquanto ela acontece. Foi feito para o Rio DX Group (RDX), clube brasileiro de radioamadorismo.
Num contest, estações de vários lugares tentam fazer o maior número de contatos de rádio (QSOs) dentro de um período. Cada operador registra os contatos num programa de log, como o N1MM Logger+, e vê a própria pontuação. O que falta é uma visão do grupo: quem está na frente agora, em que banda e com quantos QSOs.
O projeto preenche essa lacuna. Ele recebe os pacotes UDP que os programas de log já sabem enviar, processa cada um e publica um ranking ao vivo no navegador. O operador não digita nada a mais: continua logando como sempre.
O uso real mais recente foi o Sprint Rio DX Group 2026, de 17 a 26 de outubro. Em 27 de outubro, o placar do evento tinha 34 estações, entre 41 inscrições.
O placar na tela
O placar aparece em dois lugares: no site, aberto ao público, e no cliente instalado na estação.
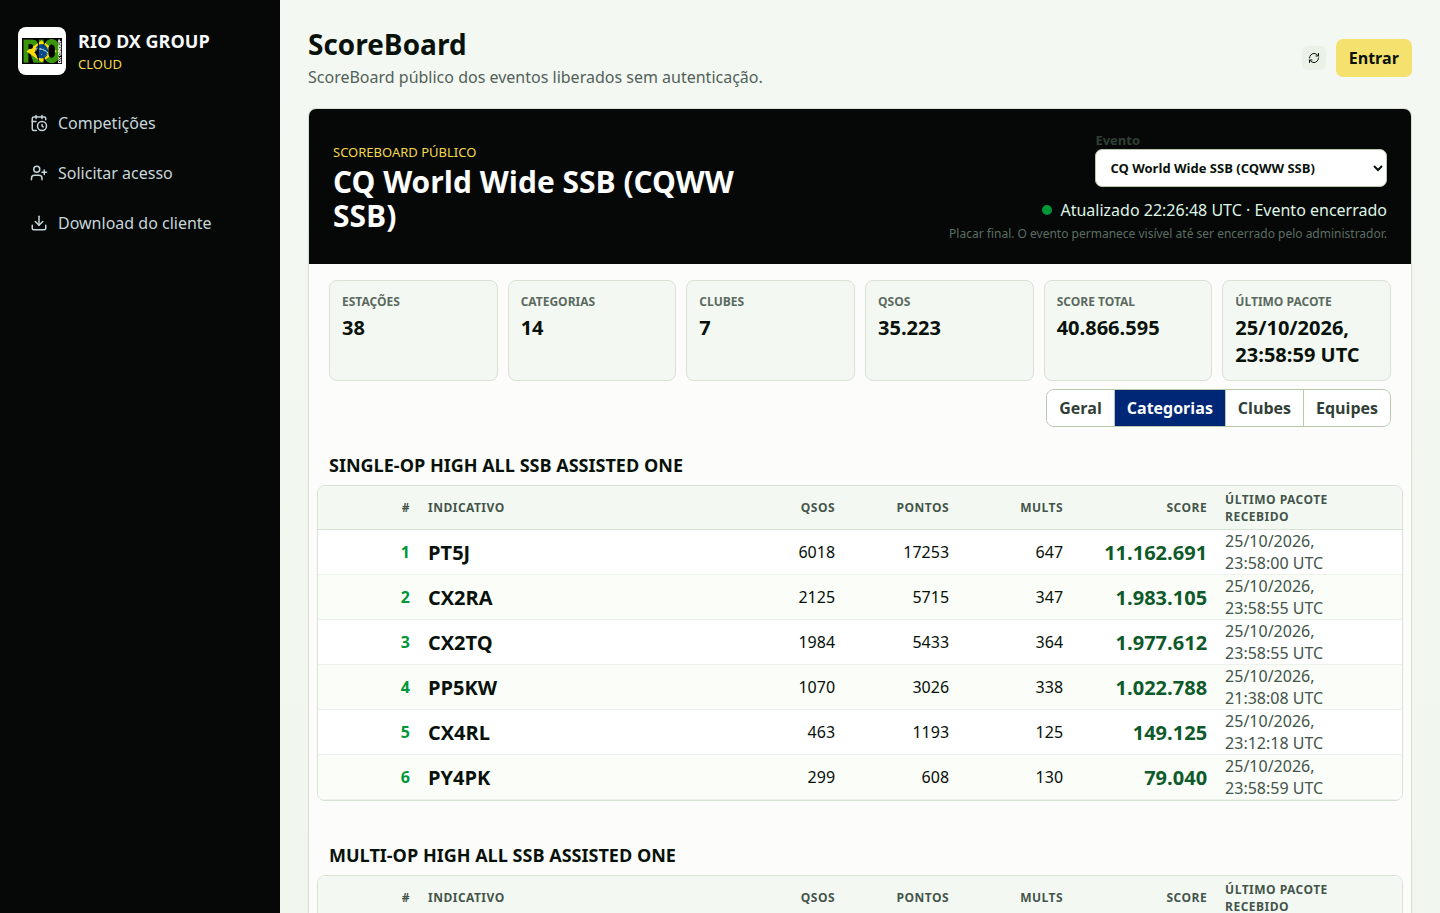
No site, qualquer pessoa acompanha o evento sem login. A imagem mostra o placar final real do CQ WW SSB 2026, capturado em 2 de novembro de 2026.
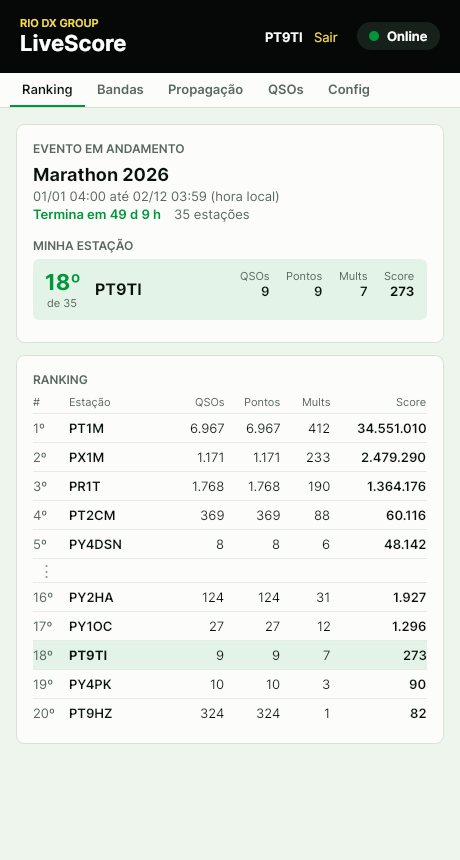
No cliente, o operador vê a própria posição e as estações mais próximas, sem sair do log. Esta imagem usa dados de exemplo, gerados pela ferramenta de testes do cliente.
Como funciona
Cada pacote percorre o mesmo caminho: chega ao servidor, entra numa fila, é processado e gravado, e só então aparece no placar.
O worker escolhe o evento pelo status, pela janela de tempo e pelo nome do contest informado no pacote. Sem evento compatível, o pacote fica guardado sem vínculo, e o tráfego fora de hora não contamina o ranking.
Como o bruto fica no banco, os dados derivados podem ser reconstruídos depois. Esse reprocessamento é uma ação do administrador e volta a aparecer nas decisões abaixo.
Se o processamento falhar de forma inesperada, a mensagem vai para uma fila de mensagens mortas, e a fila principal continua andando.
Tecnologia utilizada
O servidor é Python assíncrono, a interface é React e o cliente da estação é .NET. Tudo no servidor roda em Docker Compose.
| Parte | Tecnologia | O que faz |
|---|---|---|
| API e recepção UDP | Python, FastAPI, uvicorn, asyncio | Escuta a porta UDP 12060 e serve REST e WebSocket |
| Worker | Python, aio-pika | Consume a fila e aplica as regras de cada pacote |
| Fila | RabbitMQ 4 | Separa a recepção do processamento |
| Banco | MySQL 8.4, asyncmy | Guarda pacotes brutos e dados derivados; 26 migrations até aqui |
| Interface web | React, TypeScript, Vite | Placar, inscrições, área pessoal e administração |
| Cliente da estação | C#, .NET 9, Avalonia 11, SQLite | Fica na bandeja do Windows e entrega os pacotes por HTTPS |
| Testes | pytest, dotnet test | Cobrem o servidor e o cliente; o cliente também gera imagens da tela sem abrir janela |
O cliente aceita pacotes do N1MM Logger+, DXLog, WSJT-X, JTDX, Log4OM e Ham Radio Deluxe, todos na mesma porta. O MSHV está documentado, mas ainda não foi testado com pacotes reais.
Decisões tomadas
A decisão que sustenta as outras é tratar o pacote bruto como fonte de verdade: o placar sempre pode ser refeito a partir dele.
Guardar o pacote bruto, mesmo o inválido
O XML recebido vai para o banco mesmo quando o parse falha ou nenhum evento o reivindica. A exceção são os pacotes de alta frequência, como rtc e radioinfo, dos quais fica só o mais recente. Assim, corrigir um erro de regra não perde dados: basta reprocessar o evento. Foi o que aconteceu quando descobrimos que a categoria vinha aninhada no pacote rtc do N1MM: 8 estações do CQ WW SSB estavam sem categoria, e o reprocessamento resolveu. O custo é um banco que cresce a cada pacote.
Colocar uma fila entre a recepção e o processamento
O servidor UDP só publica o pacote no RabbitMQ; quem interpreta é um worker separado. Um pacote malformado ou um pico de tráfego não derruba a recepção. O custo são dois serviços a mais para operar: o broker e o worker.
Escrever um parser que não confia no formato
Cada programa de log fala um dialeto, e só os pacotes reais mostraram isso:
- O Log4OM manda XML no formato do N1MM, mas sem
<ID>. - O Ham Radio Deluxe pode mandar
<mycall>vazio, com a estação em<operator>. - A frequência vem em Hz no HRD e em dezenas de Hz no N1MM.
- O WSJT-X manda ADIF em texto sem cabeçalho, sem dizer de qual programa veio.
Por isso, o QSO sem id do logger recebe uma chave própria, feita da estação, do indicativo trabalhado e do horário. O programa ficou de fora da chave depois que o WSJT-X, enviando em dois formatos, duplicou cada QSO. O custo é que essa regra existe no servidor e no cliente, e as duas precisam mudar juntas.
Deixar o tipo de evento decidir de onde vem o score
Num contest, vale o score calculado pelo logger, que conhece as regras daquela competição. No DX Marathon, o servidor ignora esse score e apura países e zonas a partir dos QSOs. Isso permite que um mesmo QSO do CQ WW conte em três placares: o do contest, o do Sprint e o do Marathon anual. O custo apareceu em números diferentes: uma estação mostrava 1178 QSOs num placar e 1153 no outro. O motivo real foi que o envio começou 23 minutos depois do início, e 31 QSOs nunca chegaram como contato. Isso deu origem à importação de logs Cabrillo e ADIF.
Trocar o relay UDP por um cliente com entrega garantida
Os primeiros relays em Python e C# só repassavam o UDP. O cliente Windows, criado em outubro, grava cada pacote em SQLite antes de enviar e só o dá por entregue quando o servidor confirma. Se a internet cair, os pacotes esperam e seguem na ordem; o servidor ignora os repetidos pelo id. O custo é manter um instalador e um ciclo de versões, hoje na 1.4.0, só para Windows 10 e 11. Para conter esse custo, os formulários ficam no site, e o cliente apenas avisa e abre o link.
A fila indisponível no servidor também conta como falha: o lote continua pendente no computador da estação.
Recalcular em lote, não a cada QSO
O score do Marathon depende de todos os contatos da estação: cerca de 300 ms para 9 mil QSOs. Quando alguém reenviava o log, a fila ficava parada por minutos. Agora o worker marca a estação e a recalcula uma vez a cada poucos segundos. O custo é um placar do Marathon alguns segundos atrasado, o que não muda o resultado.
Enviar só o que mudou para o navegador
Ao conectar, o navegador recebe o ranking inteiro pelo WebSocket; depois, só as diferenças. As atualizações de um evento são agrupadas em janelas de 200 ms, para que uma rajada de pacotes não vire uma rajada de consultas. O custo é o servidor guardar o último estado enviado.
Usar WebSocket, mesmo com tráfego de mão única
O placar usa WebSocket, embora os dados só desçam do servidor para o navegador. O único recado do navegador é um __ping__ a cada 20 segundos, que o servidor lê e descarta. Por isso, SSE também atenderia.
| Critério | WebSocket (em uso) | SSE (alternativa) |
|---|---|---|
| Direção | Duas vias, com só uma usada para dados | Uma via, o que o placar precisa |
| Reconexão | Código próprio, com espera de 1 a 10 s | Nativa no EventSource |
| Ao reconectar | Recebe um novo ranking completo | Igual; o Last-Event-ID não faria falta |
| Conexão parada | Ping do navegador a cada 20 s | Exigiria um heartbeat do servidor |
| nginx | Precisa de Upgrade e timeout longo |
Precisaria de buffering desligado e timeout longo |
| Autenticação | Cookie httpOnly |
Cookie httpOnly |
Escolhi WebSocket porque já conhecia a tecnologia e o FastAPI tem suporte direto. Ele entrou em 25 de maio de 2026, junto com a fila. Hoje, migrar eliminaria o código de reconexão e o ping, mas não mudaria o que o usuário vê. O custo de ter ficado com WebSocket é esse pouco código a mais.
Foi uma escolha por familiaridade, não por necessidade técnica.
Ligar recursos por evento, desligados por padrão
Inscrição, importação de log e “aceitar apenas inscritos” são opções de cada evento. Um recurso novo não muda um evento em andamento. O custo é lembrar de ligar a opção e, em alguns casos, reprocessar o evento depois.
Uso em produção
Os dois eventos de outubro mostram um uso muito concentrado: poucas estações muito ativas e uma longa cauda de participações menores.
Os totais não podem ser somados. Um QSO do CQ WW também conta no Sprint, e as duas contagens vêm de fontes diferentes: o score do logger no CQ WW e os contatos recebidos no Sprint.
O uso vem em ondas, com os maiores picos nos fins de semana de contest.
No mesmo período, passaram pelo sistema 96 indicativos e 10 eventos, com 71 usuários cadastrados. O dia mais movimentado teve 39 indicativos enviando dados. Só 0,04% dos pacotes deram erro de parse, e 2% ficaram sem evento.
Na média, essa hora de pico equivale a cerca de 6 pacotes por segundo. O maior minuto teve 1.157 pacotes, e o maior segundo, 88.
A maior parte do tráfego é score, não contato:
| Tipo de pacote | Pacotes | Parcela |
|---|---|---|
Score (dynamicresults, rtc) |
965.635 | 65,1% |
Spots de DX (spot) |
388.082 | 26,1% |
Contatos (contactinfo, contactreplace, contactdelete) |
104.816 | 7,1% |
Rádio (radioinfo) |
17.409 | 1,2% |
| Outros | 8.277 | 0,6% |
As contagens de rtc e radioinfo ficam abaixo do tráfego real, porque hoje só o pacote mais recente desses tipos fica no banco.
Testes de stress
A fila absorveu rajadas muito acima da capacidade do worker, e o WebSocket entregou todas as atualizações até 8.000 conexões. O teste rodou numa cópia local da stack, não na produção, então os números valem como ordem de grandeza.
A máquina tinha 16 threads e 31 GB, com um worker de concorrência 4, o padrão de produção. O gerador de carga rodou no mesmo computador, sem passar pela internet e sem nginx.
Nenhum pacote recebido se perdeu depois da fila: sem erros no worker e com a fila de mensagens mortas vazia. As perdas aconteceram antes de o pacote entrar na fila, e a causa exata não foi investigada. Acima de 390 pacotes por segundo, o placar apenas atrasa enquanto a fila esvazia. O maior segundo real, com 88 pacotes, fica bem abaixo disso, mas a produção é menor que a máquina do teste: 6 núcleos e 11 GB. O cliente Windows não entrou neste teste; pelo desenho, ele reenviaria o que não fosse confirmado.
O teste revelou um limite: com o padrão do container, a API aceitou só 1.002 conexões, e as demais falharam. Com o nofile em 65.535, as 8.000 conectaram e receberam todas as atualizações, usando cerca de 2,1 GB de memória na API. O cenário tinha 50 estações e uma mudança de score a cada 2 segundos, então não mede muitas mudanças simultâneas. A produção também usava o limite de 1.024 e passou para 65.535 depois do teste. Agora, o limite vem do nginx do servidor, bem acima dos 71 usuários cadastrados.
Onde o projeto está
O sistema está em produção em cloud.riodxgroup.com. São mais de 200 commits desde 9 de maio de 2026, cerca de 140 deles em outubro, o mês do Sprint.
Três aprendizados ficaram desse período:
- Pacote real vale mais que especificação. As diferenças de formato apareceram em testes com estações reais, durante os eventos.
- Regra de competição muda rápido. Em 15 de outubro, o Marathon passou a contar 2 m e 70 cm. No dia seguinte, a contagem voltou a 160–6 m, para seguir o regulamento do Sprint. Com o histórico guardado, voltar atrás custa pouco.
- Teste de carga acha o que o uso real esconde. O limite de 1.024 arquivos estava em produção e só foi percebido quando um teste o atingiu.
Continuam fora do escopo o Challenge por banda e a exportação ADIF. O suporte ao Windows 7 e 8.1 também ficou para depois, por falta de máquina de teste.